最近公司接到了一个来自客户方的技术课题:希望我们帮助他们,对历史积累的车辆信号数据湖做一次语义建模和数据治理,以便未来让这些数据能和 AI Agent 结合起来,发挥更大的作用。
接到课题后,我快速调研了一下。从理论层面看,这本质上是如何把 ontology 真正用到实际工程场景里。回头看,过往的工程实践中或多或少都有类似的做法,但确实不成体系。
所以这次我就借助一个小 demo,帮自己把 ontology 工程应用的概念系统地扫盲一遍。这篇博客记录了我的学习过程,以及 demo 是如何把理论和实践结合起来的。
Ontology 在实践中包含什么
实践中的 ontology,一般包含四部分:概念、映射、关系、规则。
简单理解:
- 概念:定义业务对象及其含义、单位和常用叫法。
- 映射:记录概念到物理存储位置的对应关系。
- 关系:描述概念之间的归属和关联,决定查询时是否需要关联多张表。
- 规则:记录业务上的判断口径,比如阈值和持续时间。
换句话说,数据库记录数值,ontology 记录数值的含义、位置和用法。
归纳概念时,一般从业务提问和常用术语入手,把同义叫法收拢到同一个概念,并区分实体与度量。实体如车辆、电池,表示业务对象;度量如电池温度、车速,表示可观测的数值,并附带单位和别名,方便检索时对上不同的问法。
做映射时,先盘点物理表和列,再建立概念到 table.column 的对应,并集中存放一处。同一概念只对应一个位置,查询时按映射取数,不在代码里分散硬编码。多源同义字段需要先收敛口径,再写入映射。
梳理关系时,记录归属与关联。归属说明概念属于谁,关联说明哪些概念需要联合查询。存在关联的两个概念在查询时需要 JOIN,不存在关联则各自独立查询。
沉淀规则时,把业务判断写成可执行的口径,包括引用的概念、比较方式、阈值、单位和持续时间。阈值放在规则而非代码中,口径变化时只需修改规则。
Demo 背景:三层结构与四个页面
该 demo 模拟车辆信号数据:3 辆车,5 张表,覆盖车辆基础信息、电池测量、车辆测量、刹车测量,并建有时间索引。
数据按业务逻辑生成:每天 2–3 个行程窗口,停车时车速接近 0,行驶掉电、夜间充电回满,温度平时 30 到 45 度之间随车速起伏,偶发 50 多度的持续高温,刹车平时 0 到 100 bar,偶发 150 bar 以上的急刹。
系统分三层:上层为语义层,下层为 SQLite,中间为 Agent。请求先查语义,再拼 SQL,再查库。
flowchart TD
    U[用户提问] --> A[Agent]
    A --> S[语义层]
    S --> Q[Query Plan]
    Q --> SQL[SQL]
    SQL --> DB[(SQLite)]
    DB --> R[查到行]
    R --> A
页面有四个:聊天、语义浏览、数据库浏览、SQL 练习场。提问在聊天页,映射的查看和修改在语义页。
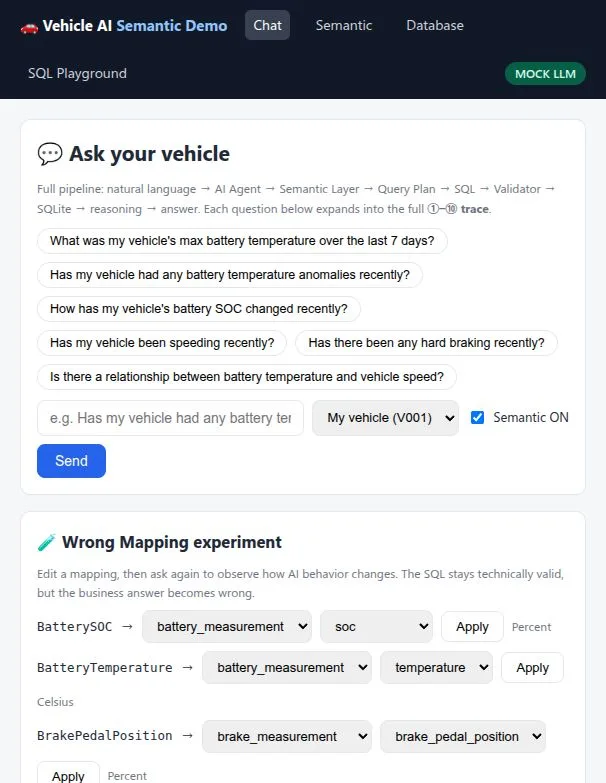
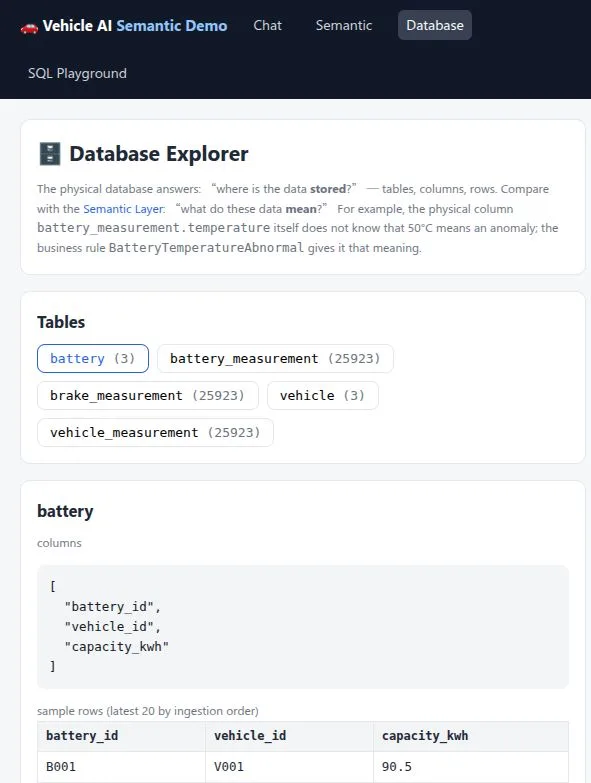
物理表的抽查在数据库页,以 battery 表为例,可见列与样例行:
核心设计:四个 JSON 文件如何分工
该 demo 的技术栈很简单:后端为 Go(标准库 net/http 对外提供服务),数据库为 SQLite(modernc.org/sqlite 纯 Go 驱动,无需 CGO),语义层为本地 JSON 文件,前端为无框架 HTML + CSS + Vanilla JS。Agent 有两档驱动:默认 MOCK(无需 API Key,确定性规则链路),另支持 OpenAI-compatible 的真实 LLM。
目录结构如下:
sementic-ai/
├── main.go                  # 装配:.env → SQLite+seed → catalog → agent → :8080
├── agent/                   # AI Agent:意图识别、QueryPlan、SQL 生成、结果推理
├── semantic/                # 语义层 Go 实现:catalog + 检索
├── semantic_data/           # 语义层数据:4 个 JSON
├── database/                # 物理层:SQLite 建表、seed、只读查询
├── tools/                   # Agent 可调用的两个 Tool:查语义、执行 SQL
├── validator/               # SQL 校验:只读、单语句、表白名单
├── server/                  # net/http 服务:页面 + JSON API
└── web/                     # 前端:HTML + CSS + Vanilla JS
该项目的建模成果由 semantic_data/ 下的四个 JSON 承载,Go 侧由 SemanticCatalog 提供 Search / GetMapping / GetRule 等方法,供 Agent 在运行时查询。
concepts.json 存放 7 个概念。Vehicle、Battery 为 entity,BatteryTemperature、BatterySOC、VehicleSpeed、BrakePressure、BrakePedalPosition 为 measurement:
"BatteryTemperature": {
  "description": "Temperature measurement of the vehicle battery",
  "type": "measurement",
  "unit": "Celsius",
  "keywords": ["battery temperature", "temperature", "thermal", "overheat"]
}
概念附带单位和常用叫法(含中文别名),用于语义检索。例如提问涉及刹车时,可对上 BrakePressure 和 BrakePedalPosition。
mappings.json 记录概念到物理位置的对应关系:
"BatteryTemperature": { "table": "battery_measurement", "column": "temperature" },
"VehicleSpeed": { "table": "vehicle_measurement", "column": "speed" }对应关系只存于此处,agent/ 和 tools/ 中生成 SQL 的逻辑不硬编码表名,运行时必须调用 GetMapping() 才能确定查询位置。
relationships.json 描述概念之间的关系:
"BatteryTemperature": {
  "belongs_to": ["Battery", "Vehicle"],
  "related_to": ["VehicleSpeed"]
}
has / belongs_to / related_to 决定多概念联合查询时是否需要 JOIN。例如温度和速度的联合分析能够成立,是因为两者之间存在 related_to。
business_rules.json 存放 3 条业务规则:
"BatteryTemperatureAbnormal": {
  "concept": "BatteryTemperature",
  "operator": ">", "threshold": 50,
  "minimum_duration_minutes": 5
}
另有超速 120、急刹车 150 两条。这些阈值不存在于数据库中,temperature 列本身也不包含 50 度是否异常的信息。阈值放在 JSON 而非代码中,调整口径时只需修改数据文件。
四个文件的关联为:概念是基础,映射将概念绑定到 table.column,关系决定多概念查询时的关联方式,规则引用概念给出判断口径。Agent 的运行时顺序也是沿此链路:Search 定位概念,GetMapping / GetRule 取位置和阈值,再拼 QueryPlan 和 SQL。
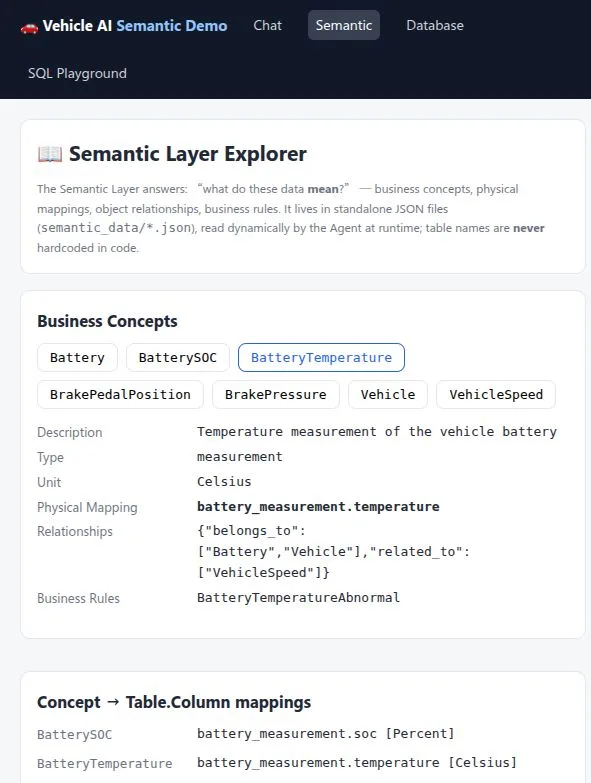
语义页将上述内容集中展示,以 BatteryTemperature 为例,可见描述、单位、物理映射、关系与规则:
JSON 只是承载建模成果的方式之一,适用于规模小、改动频繁的阶段。同样的内容也可以用 RDF/OWL 加三元组存储、属性图数据库(如 Neo4j)、关系表、配置中心或语义平台、代码注解等方式承载。方式不同,概念、映射、关系、规则这四部分仍然存在,差异主要在查询、版本管理和规模化能力上。
一次完整问答是怎么跑起来的
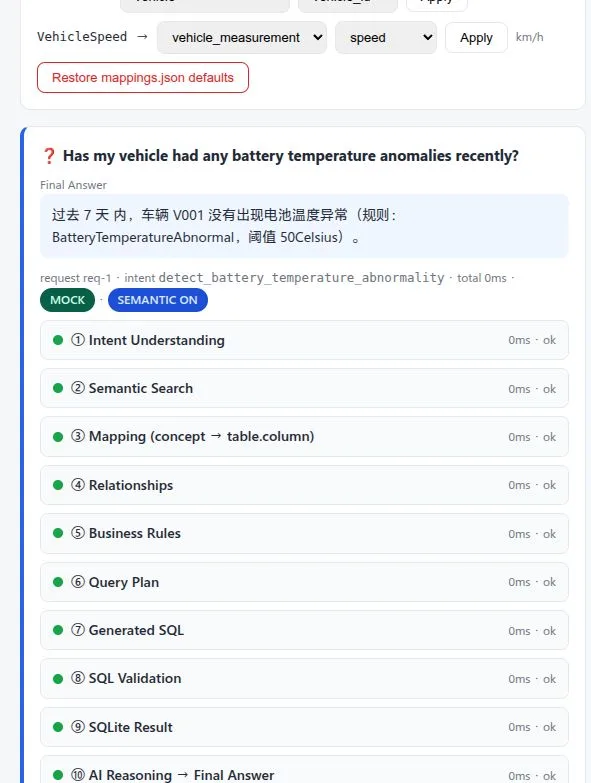
以提问“我的车最近有没有电池温度异常?”为例,页面上的 Trace 展开后包含以下步骤。
先识别意图,确定为电池温度异常查询,车辆默认为 V001,时间为最近 7 天。再以 battery temperature abnormal 检索语义目录,命中 Battery、BatteryTemperature。随后以概念名获取映射,确定查询 battery_measurement.temperature,并获取规则,确定为 50 度、持续 5 分钟。
具备上述信息后,拼出 QueryPlan,再拼出 SQL:
SELECT timestamp, temperature AS value FROM battery_measurement
WHERE vehicle_id = 'V001'
AND timestamp >= datetime('now','-7 days')
AND temperature > 50
ORDER BY timestamp
之后经过校验、查库。该次运行未查到满足规则的持续超阈值分组,最终返回无异常的中文答案。
flowchart LR
    Q[提问:最近有没有电池温度异常] --> I[认意图]
    I --> S[查语义目录]
    S --> P[拼 Query Plan]
    P --> G[拼 SQL]
    G --> V[校验]
    V --> D[(查 SQLite)]
    D --> R[按规则分组,回答案]
ontology 起作用的位置有两处:一处在拼 SQL 之前,查询位置和阈值均来自语义目录,而非硬编码;另一处在拿到数据行之后,异常事件的分组依据同样来自规则中的描述。
下图为该次提问的实际 Trace,①–⑩ 全部通过:
有没有语义层,差别在哪里
聊天页提供语义开关(Semantic ON/OFF),默认为开启。提问时,该选项以 semantic_enabled 传入 /api/chat,控制 Agent 是否经过语义目录:开启时先查目录再生成 SQL,关闭时跳过语义步骤直接生成 SQL。该开关用于对比有无语义层时的行为差异,语义页另提供映射修改与恢复接口,用于映射错误实验。
开启时,流程为先查语义目录,再生成 SQL。查询位置和阈值均来自映射和规则。
关闭后,语义检索、映射获取、关系获取、规则获取几步直接跳过,SQL 由模型按表名列名猜测生成。例如生成 SELECT temperature FROM battery ...,查库时报错 no such column: temperature,实际表名为 battery_measurement。缺少语义层时,业务词的含义(如异常是多少度、持续多久才算)也无法确定。
另有一个映射错误实验:将 BatteryTemperature 的映射从 temperature 改为 voltage,再提问最高电池温度。QueryPlan 显示 MAX(voltage),SQL 合法,校验全部通过,数据库正常返回 411.0,最终答案为最高 411.0°C。链路上无任何报错,但业务答案明显偏离。
两组对比表明:SQL 正确仅覆盖语法合法、表列存在、只读等条件,业务正确还取决于概念是否查对、阈值是否用对。校验负责前者,语义层负责后者。
本文更多从现象层面说明 ontology 的构成与运行方式,未覆盖版本管理、口径冲突、大规模推理等更复杂的工程场景,可作为入门阶段的参考。